CUSTOMER
客户中心
助力生命健康领域从基础研究到产业化的加速转化
CUSTOMER
客户中心
助力生命健康领域从基础研究到产业化的加速转化
近年来,随着高通量测序、质谱蛋白质组学以及人工智能技术的发展,生物信息学正在推动药物研发模式发生改变。传统药物筛选通常依赖大量实验验证,而基于多组学数据的计算模型能够从复杂生命数据中挖掘潜在规律,实现药物作用机制解析和治疗响应预测。
近期,发表于国际顶级期刊《Nature》的一项研究An operational perturbation proteomics-based virtual cell model开发了一种基于动态蛋白质组学的人工智能虚拟细胞模型一ProteinTalks。该研究通过整合 大规模蛋白质组数据、生物信息学分析和深度学习算法,模拟药物作用过程中细胞状态变化,实现癌症药物响应预测和精准治疗分析。
传统生信分析通常关注某一时间点的基因或蛋白表达差异,例如寻找差异表达基因、富集分析关键通路等。然而,药物作用过程是一个动态调控过程,细胞受到药物刺激后,蛋白表达网络会随时间不断变化。
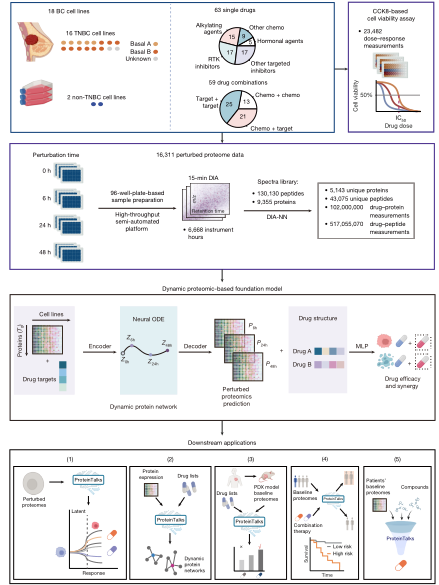
为了捕捉这种动态响应,研究团队建立了大规模药物扰动蛋白质组数据库。
研究选取:
18种乳腺癌细胞系;
63种FDA批准药物;
并在0h、6h、24h和48h多个时间点进行蛋白质组检测,获得超过3800万组时间序列蛋白丰度数据。
这些动态数据为后续人工智能模型训练提供了重要的数据基础。
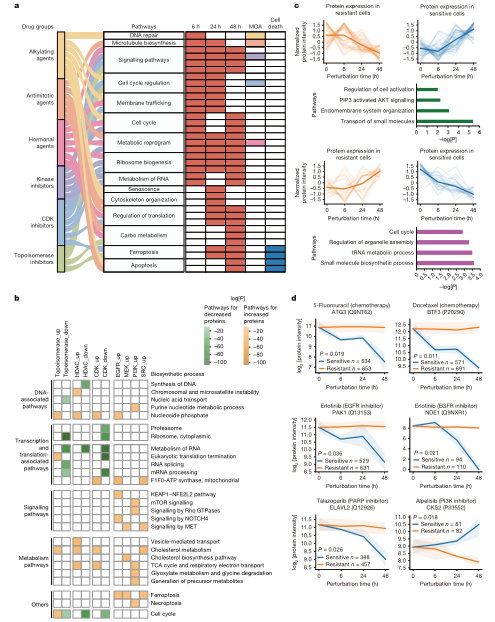
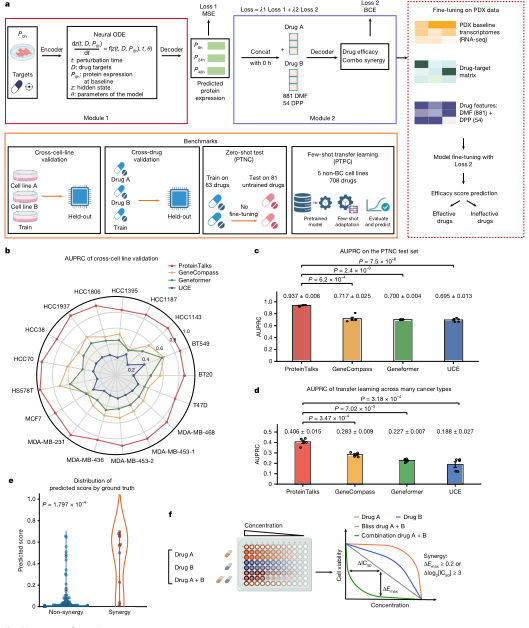
基于药物扰动蛋白质组数据,研究团队构建了ProteinTalks虚拟细胞模型。
该模型整合:
基线蛋白质组表达数据;
药物分子结构信息:
药物靶点信息。
通过神经ODE(Neural Ordinary Differential Equation)算法模拟蛋白表达随时间变化的轨迹,并利用深度学习模型预测:
药物治疗效果;
药物敏感性变化;
药物联合治疗协同作用。
相比传统基于单一组学特征的预测方法,ProteinTalks能够学习药物作用过程中的动态分子变化模式,提高药物响应预测能力。
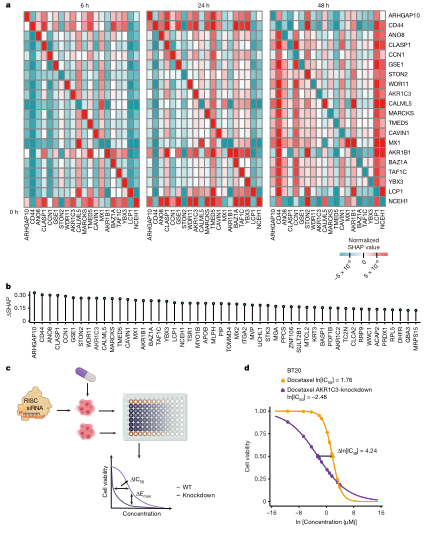
人工智能模型虽然能够完成预测,但模型内部规律需要进一步解释。
研究团队利用生物信息学解释方法,对ProteinTalks预测结果进行解析。
通过:
SHAP特征贡献分析;
关键蛋白筛选;
基因功能验证;
研究人员发现了一系列影响药物敏感性的核心蛋白。
随后结合siRNA敲低实验,对模型预测的重要蛋白进行实验验证,证明生信模型发现的关键分子确实参与药物响应调控。
这一过程实现了:
计算预测一关键分子发现实验验证的研究闭环。
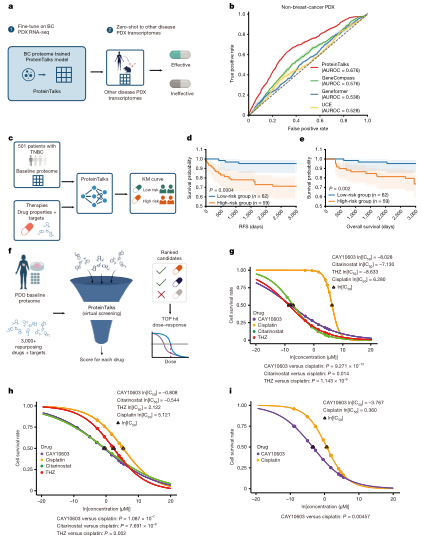
为了验证模型的临床应用价值,研究团队进一步将ProteinTalks应用于患者样本分析。
利用患者来源蛋白组数据,模型能够:
预测患者药物响应;
区分不同治疗风险群体;
筛选潜在有效药物。
此外,研究结合患者来源类器官(PDO)模型进行药物验证,将计算预测结果与真实生物实验结果进行匹配。
这一策略将:
生物信息学分析+人工智能模型+类器官实验
相结合,为未来精准治疗和个体化药物筛选提供新的研究模式。